用现成的紫微命盘解读数据训练和微调 AI
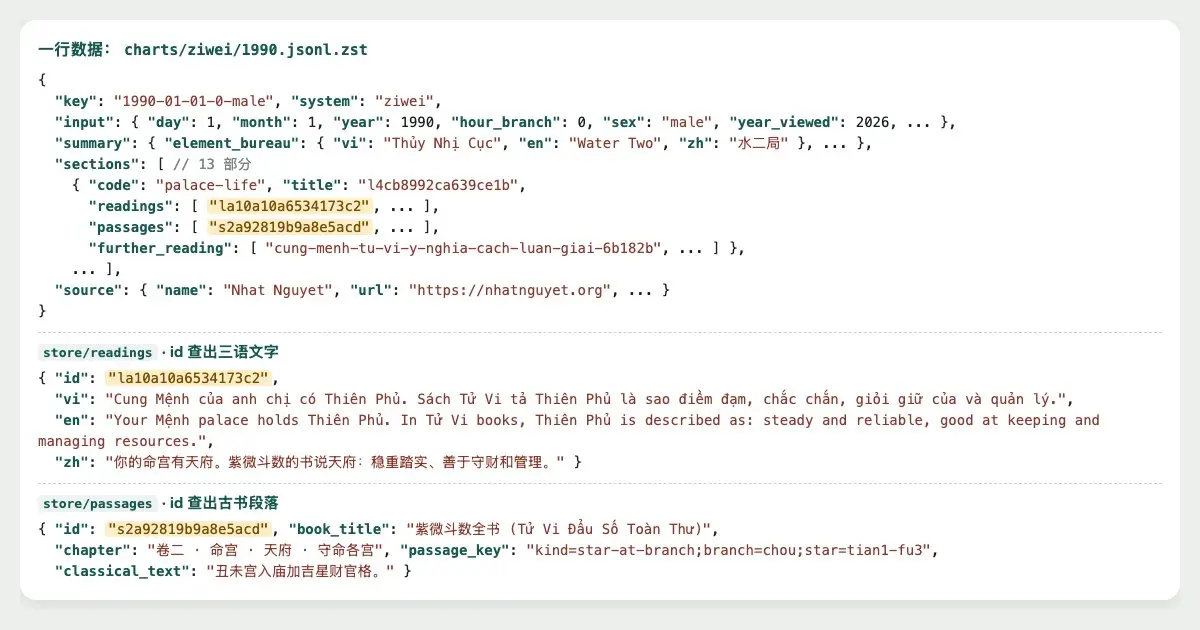
Nhat Nguyet 的命盘解读数据集可直接用于微调语言模型:每张命盘一行 JSON,每部分有三种语言的解读,古书段落注明书名和章节,采用 CC BY 4.0 许可。 本文说明如何读取一行数据,并把它变成微调用的问答对。
数据集已发布在 Hugging Face:nhatnguyet/ziwei-readings(紫微)、nhatnguyet/bazi-readings(八字)、nhatnguyet/numerology-readings(生命灵数)。目录名和字段名为英文;越南语文字在 vi 字段中。
数据集由哪些文件组成?
命盘文件按出生年份分开,用 zstd 压缩(扩展名 .jsonl.zst),每行一个 JSON 对象。用 Python 读取请先 pip install zstandard。
charts/ziwei/<年份>.jsonl.zst:每行一张命盘,行内文字以 id 代替。store/readings/ziwei.jsonl.zst、store/passages/ziwei.jsonl.zst、store/further-reading/ziwei.jsonl.zst:id 指向的库(解读文字、古书段落、文章),每类一个文件。assembled/ziwei/<vi|en|zh>/<年份>.jsonl.zst:已按一种语言拼好的文字,markdown 格式。meta.json:各目录的结构、id 的生成方式、许可,以及三种语言的出处说明。
只需要文字的话,直接读 assembled:每行是 {key, system, lang, input, text},其中 text 是一张命盘的完整解读。需要逐部分、逐段古书时,按下文把 charts 与 store 一起读。
一行命盘数据包含什么?
紫微命盘有 13 部分:总论和十二宫。
| 键 | 内容 |
|---|---|
key | 命盘编号:出生日期、时辰序号、性别(1990-01-01-0-male) |
input | 输入:日、月、年、时辰、性别、流年 2026 |
summary | 结构化命盘:五行局、纳音、命宫地支、格局、大运、流年,三种语言齐全 |
sections[].code | 部分代码:overview、palace-life…… |
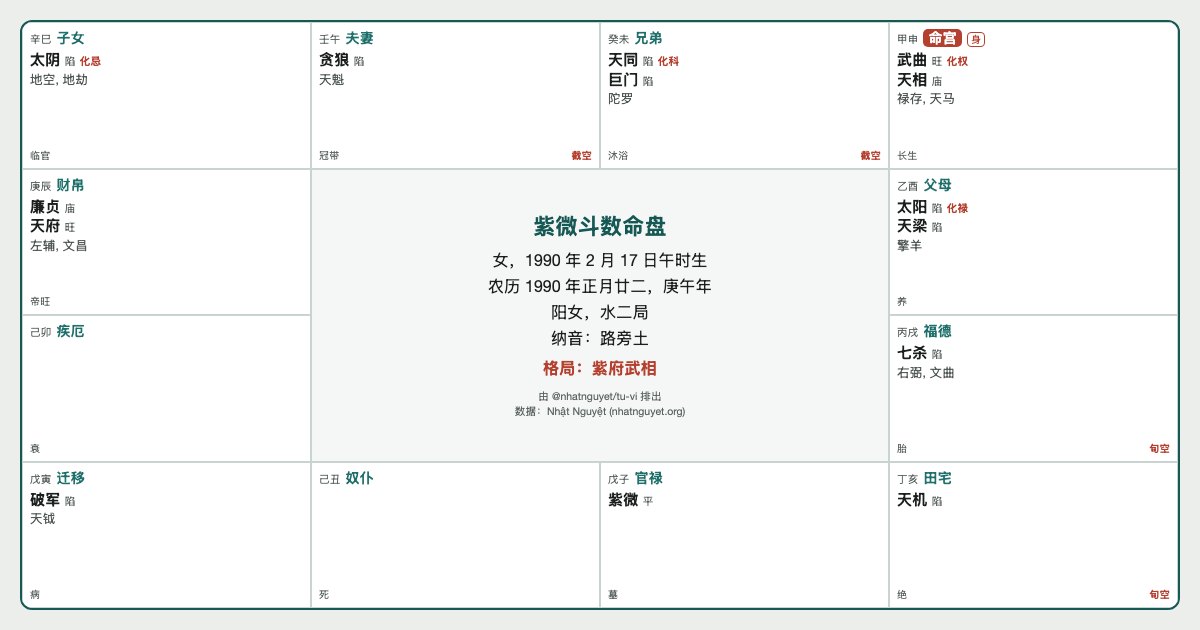
sections[].chart | 该部分的宫位:地支、干支、诸星及其庙陷 |
sections[].title、sections[].readings | 部分标题与每段解读的 id,在 store/readings 中查出 vi、en、zh;由计算核心生成,不是模型写的 |
sections[].steps | 推算步骤(安命宫、定局……),每步的 name、input、formula、intermediate、result 都是 store/readings 中的 id |
sections[].passages | 公有领域古书段落的 id,在 store/passages 中查出书名、作者、章节、检索键、原文 |
sections[].further_reading | 文章的 slug,在 store/further-reading 中查找 |
source | 出处的名称、网址、许可和出处说明 |
构建微调集的步骤
- 下载
meta.json、所需年份的charts/ziwei/1990.jsonl.zst和解读库store/readings/ziwei.jsonl.zst,例如用hf download nhatnguyet/ziwei-readings meta.json charts/ziwei/1990.jsonl.zst store/readings/ziwei.jsonl.zst --repo-type dataset --local-dir .(hf命令随huggingface_hub安装)。 - 把解读库载入为从 id 到三语文字的查找表。
- 逐行读取命盘;每个有解读的部分,每种语言各成一个样本。
- 问题由该命盘自身的
input和summary组成;答案是readings中的 id 查出文字后拼接而成。 - 给每个样本附上与其语言一致的出处说明:
meta.json的attribution含vi、en、zh。 - 按多数微调工具可读的
messages格式写成 JSONL。
import io, json
import zstandard  # pip install zstandard

def read(path):
    """读取 .jsonl.zst 文件,每行一个 JSON 对象。"""
    with open(path, "rb") as f:
        for line in io.TextIOWrapper(zstandard.ZstdDecompressor().stream_reader(f), encoding="utf-8"):
            yield json.loads(line)

# 解读库:id -> {vi, en, zh},整个数据集一个文件。
TEXT = {x["id"]: x for x in read("store/readings/ziwei.jsonl.zst")}
CREDIT = json.load(open("meta.json", encoding="utf-8"))["attribution"]  # {"vi": ..., "en": ..., "zh": ...}

TEMPLATE = {  # 各语言的问题模板
    "vi": ("Sinh {date}, giờ {hour}, {sex}. Lá {year}, {bureau}, Mệnh tại {life}. Luận {section}.", {"male": "nam", "female": "nữ"}),
    "en": ("Born {date}, {hour} hour, {sex}. Chart: {year}, {bureau}, Mệnh at {life}. Read the {section}.", {"male": "male", "female": "female"}),
    "zh": ("{date}生,{hour}时,{sex}。命盘:{year},{bureau},命宫在{life}。论{section}。", {"male": "男", "female": "女"}),
}

count, first = 0, []
with open("fine-tune.jsonl", "w", encoding="utf-8") as out:
    for chart in read("charts/ziwei/1990.jsonl.zst"):
        i, s = chart["input"], chart["summary"]
        for section in chart["sections"]:
            if not section["readings"]:
                continue
            for lang, (template, sex) in TEMPLATE.items():
                question = template.format(date=f"{i['day']}/{i['month']}/{i['year']}", hour=i["hour_name"][lang],
                                           sex=sex[i["sex"]], year=s["year_stem_branch"][lang], bureau=s["element_bureau"][lang],
                                           life=s["life_palace_branch"][lang], section=TEXT[section["title"]][lang])
                answer = "\n".join(TEXT[x][lang] for x in section["readings"])
                sample = {"messages": [{"role": "user", "content": question},
                                       {"role": "assistant", "content": answer}],
                          "source": CREDIT[lang]}
                out.write(json.dumps(sample, ensure_ascii=False) + "\n")
                count += 1
                if len(first) < 6:
                    first.append(sample)

print("样本数:", count)
for m in first[3:6]:
    print(m["messages"][0]["content"])
    print("  ->", m["messages"][1]["content"][:150], "...")
print(" ", m["source"])样本数: 323106
Sinh 1/1/1990, giờ Tý, nam. Lá Kỷ Tỵ, Thủy Nhị Cục, Mệnh tại Sửu. Luận Cung Mệnh.
-> Cung Mệnh của anh chị có Thiên Phủ. Sách Tử Vi tả Thiên Phủ là sao điềm đạm, chắc chắn, giỏi giữ của và quản lý.
Sách Tử Vi tả Thiên Phủ là sao kho: đ ...
Dữ liệu: Nhật Nguyệt (nhatnguyet.org)
Born 1/1/1990, Tý hour, male. Chart: Kỷ Tỵ, Water Two, Mệnh at Sửu. Read the Life Palace.
-> Your Mệnh palace holds Thiên Phủ. In Tử Vi books, Thiên Phủ is described as: steady and reliable, good at keeping and managing resources.
Tử Vi books ...
Data: Nhat Nguyet (nhatnguyet.org)
1/1/1990生,子时,男。命盘:己巳,水二局,命宫在丑。论命宫。
-> 你的命宫有天府。紫微斗数的书说天府:稳重踏实、善于守财和管理。
紫微书中称天府为库星:稳重谨慎,善于积累和管理,可靠;另一面是保守、怕冒险。在命宫(自身),天府处平之位:上述特点表现一般。
以文昌所在宫为初一,顺数至生日,再退一宫。
以文曲所在宫为初一,逆数至生日,再退一宫(越南书的排法;中国书顺数 ...
数据:Nhat Nguyet (nhatnguyet.org)1990 年的 8,760 张命盘(365 天、十二时辰、男女两性)得到 323,106 个样本,三种语言齐全;输出文件约 276 MB。1990 年的 charts 文件只有 6.7 MB,因为每句话只在库里存一次。同年的 assembled 文件越南语 18.4 MB、英语 14.8 MB、中文 12.2 MB。
训练时要注意什么?
- 越南语解读称读者为“anh chị”;用它训练的模型会沿用这种口吻。
- 古书段落是汉文原文,没有翻译。想让模型引书,就用
passages的 id 到store/passages查出段落,把book_title和chapter与classical_text放在一起,不要只留文字。 - 按命盘划分评估集,不要按样本:同一部分的三种语言版本若分在两边,分数会虚高。
- 解读依据的是紫微一派的规则,未经检验。模型学到的是该派如何读盘,而不是关于人生的真实结论;上线时请说明这一点。
许可与出处
数据采用 CC BY 4.0:可用于训练,包括商业产品,条件是注明“数据:Nhat Nguyet (nhatnguyet.org)”。古书原文属公有领域;分段、与命盘挂接、对照刻本的工作由 Nhat Nguyet 完成,同样采用该许可。