搭建能引用古书作答的 AI 助手
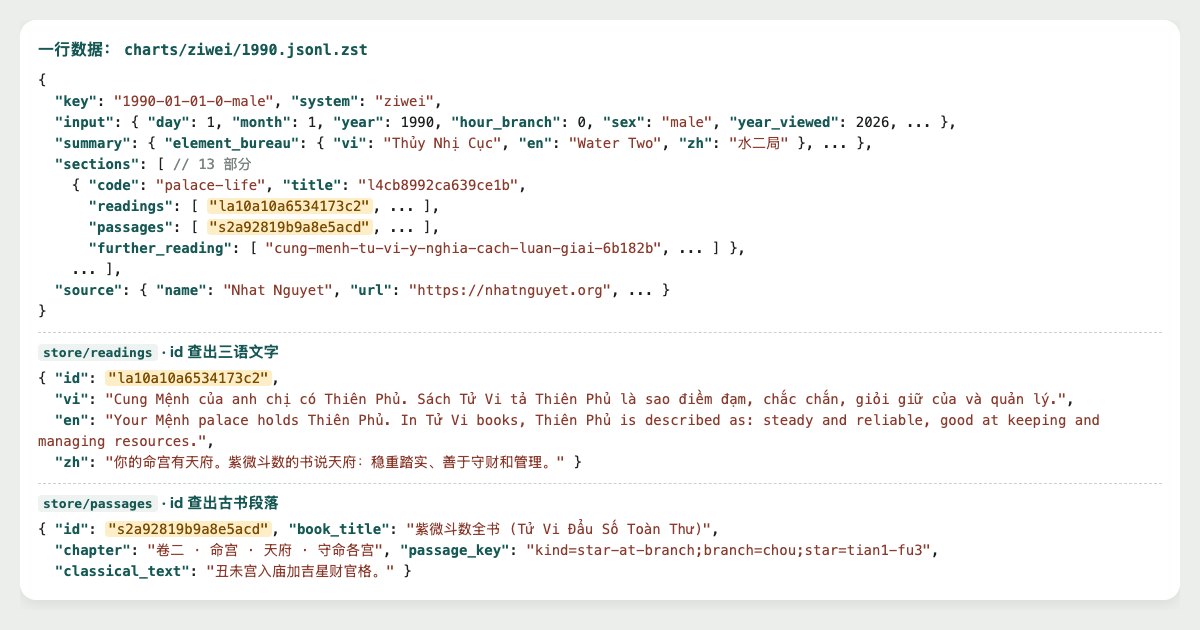
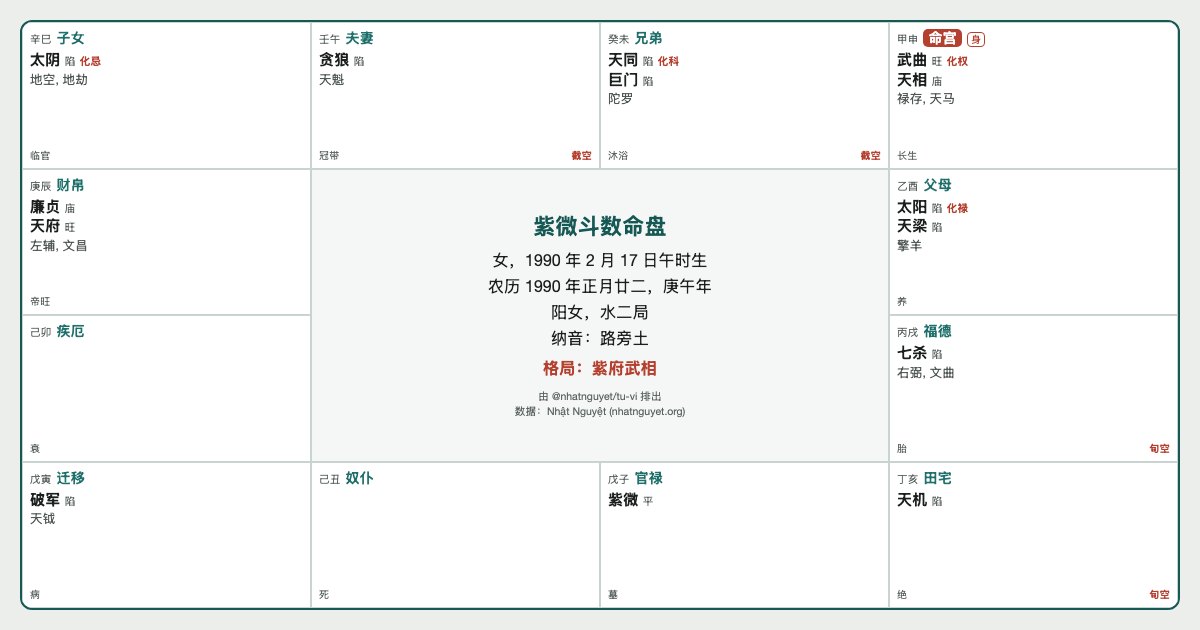
能引用古书作答的 AI 助手需要三样东西:注明书名与章节的段落库、为问题找准段落的检索,以及只依据编号段落作答的指示。 Nhat Nguyet 的解读数据集已经具备第一样:store/passages 的每段古书都带书名、作者、章节、检索键(passage_key:星、宫、格局)和原文(classical_text),命盘则通过 sections[].passages 中的 id 指向这些段落。
数据集已发布在 Hugging Face:nhatnguyet/ziwei-readings(紫微)、nhatnguyet/bazi-readings、nhatnguyet/numerology-readings。目录名、字段名和键代码均为英文。
步骤
- 载入古书段落库
store/passages/ziwei.jsonl.zst。库已去重,每段一个id。 - 按键筛选:问贪狼坐命宫,就只看键为
star=tan-lang和palace=life的段落。 - 按与问题的接近程度排序。示例统计相同的双字;实际使用请换成向量。
- 给段落编号,连同指示放进提示词:只用编号段落,每一点标
[n]。 - 显示前检查答案:引用编号必须存在,引文必须原样出现在段落里。
检索与提示词代码
文件用 zstd 压缩(扩展名 .jsonl.zst),请先 pip install zstandard,下载段落库(例如 hf download nhatnguyet/ziwei-readings store/passages/ziwei.jsonl.zst --repo-type dataset --local-dir .),再在该目录里运行。
import io, json
from collections import Counter
import zstandard  # pip install zstandard

def read(path):
    """读取 .jsonl.zst 文件,每行一个 JSON 对象。"""
    with open(path, "rb") as f:
        for line in io.TextIOWrapper(zstandard.ZstdDecompressor().stream_reader(f), encoding="utf-8"):
            yield json.loads(line)

# 第 1 步:载入古书段落库。每段一个 id,不重复;整个数据集一个文件。
passages = list(read("store/passages/ziwei.jsonl.zst"))
print("不同的古书段落:", len(passages))

# 第 2、3 步:按键(星、宫)筛选,再按与问题相同的双字数排序
def key(p):
    return dict(f.split("=", 1) for f in p["passage_key"].split(";"))

def pairs(s):
    return Counter(s[i:i + 2] for i in range(len(s) - 1))

def search(question, star, palace=None, k=3):
    candidates = [p for p in passages if key(p).get("star") == star and (palace is None or key(p).get("palace") == palace)]
    q = pairs(question)
    found, seen = [], set()  # 同一句古书可能带多个键:只取一次
    for p in sorted(candidates, key=lambda p: -sum((q & pairs(p["classical_text"])).values())):
        if p["classical_text"][:40] not in seen:
            seen.add(p["classical_text"][:40])
            found.append(p)
    return found[:k]

# 第 4 步:组装带编号出处的提示词
found = search("贪狼在命宫遇化权", star="tan-lang", palace="life")
block = "\n".join(f"[{i}] {p['book_title_original']}, {p['chapter']}: {p['classical_text'].splitlines()[0][:48]}" for i, p in enumerate(found, 1))
print(block)
print("---")
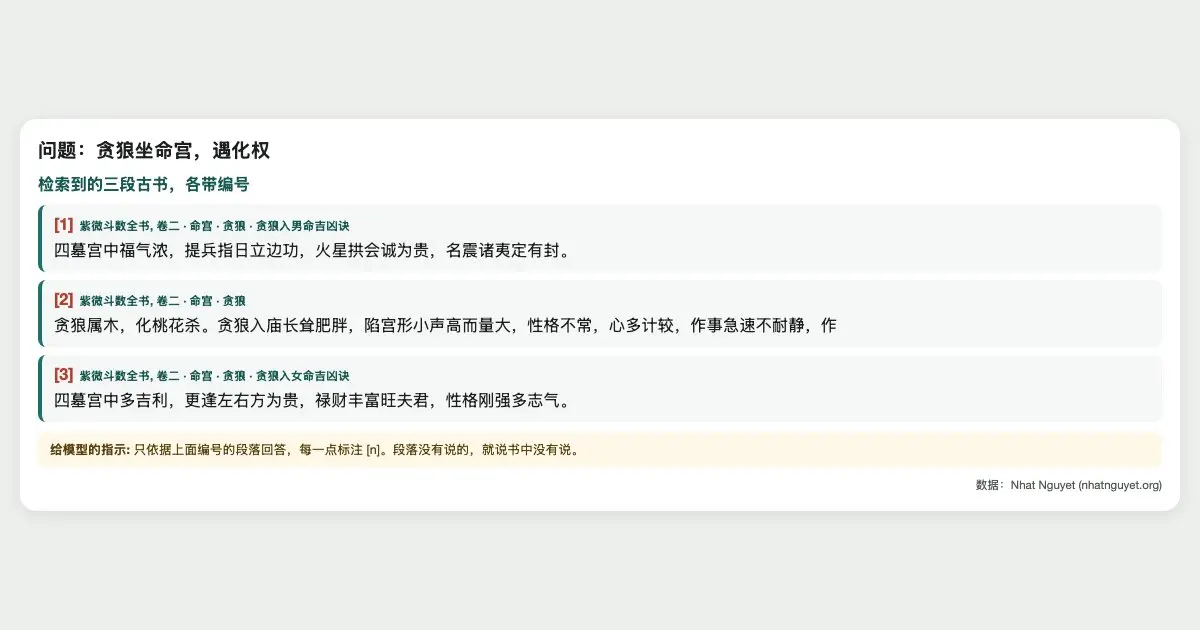
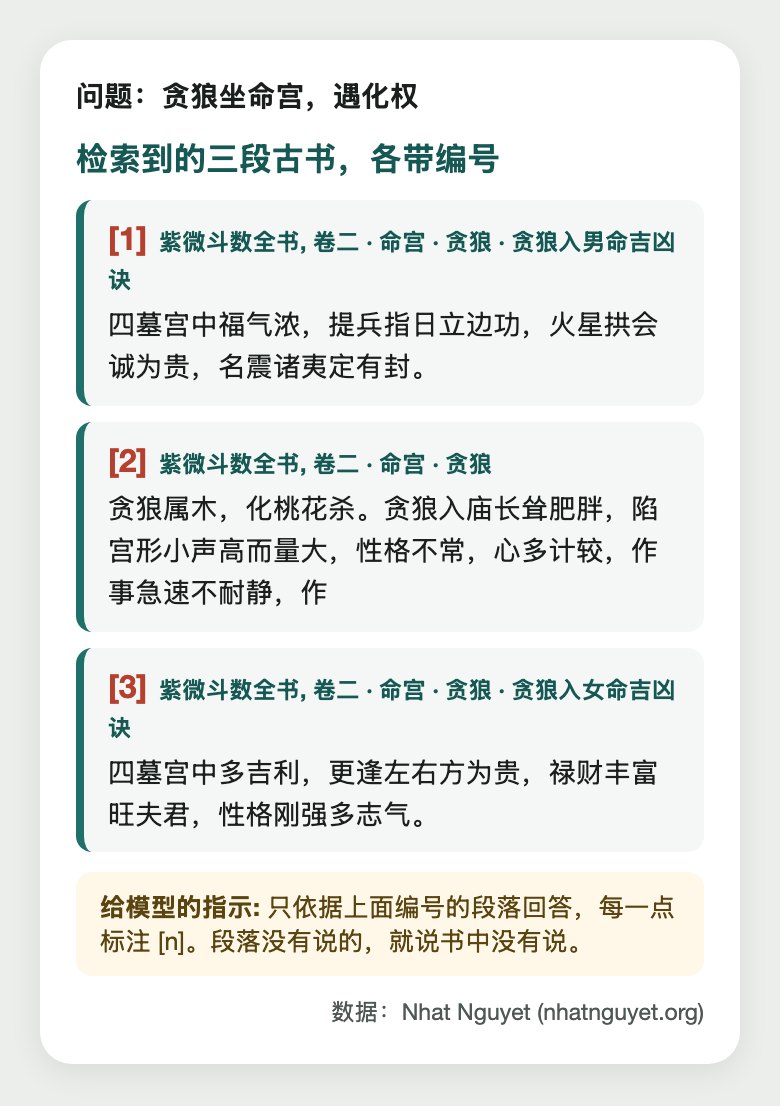
print("只依据上面编号的段落回答,每一点标注 [n]。段落没有说的,就说书中没有说。")不同的古书段落: 1015
[1] 紫微斗数全书, 卷二 · 命宫 · 贪狼 · 贪狼入男命吉凶诀: 四墓宫中福气浓,提兵指日立边功,火星拱会诚为贵,名震诸夷定有封。
[2] 紫微斗数全书, 卷二 · 命宫 · 贪狼: 贪狼属木,化桃花杀。贪狼入庙长耸肥胖,陷宫形小声高而量大,性格不常,心多计较,作事急速不耐静,作
[3] 紫微斗数全书, 卷二 · 命宫 · 贪狼 · 贪狼入女命吉凶诀: 四墓宫中多吉利,更逢左右方为贵,禄财丰富旺夫君,性格刚强多志气。
---
只依据上面编号的段落回答,每一点标注 [n]。段落没有说的,就说书中没有说。紫微古书库共有 1,015 个不同段落:1,004 段出自《紫微斗数全书》通行本,11 段出自明南阳堂刊本。1990 年的 8,760 张命盘引用了其中 984 段。传统上此书归于陈抟,罗洪先于 1550 年作序;现代研究不认为这一归属已得到证明,author_vi 和 author_en 字段也如实这样写。
显示前检查答案
模型有时会引用不存在的编号,或“引用”书里没有的话。下面的函数在文字到达读者前把两种情况都拦下。
import re

def check_answer(answer, passages):
    """每个 [n] 必须指向真实存在的段落;引号内的句子必须原文出现在该段落中。"""
    errors = []
    for n in map(int, re.findall(r"\[(\d+)\]", answer)):
        if not 1 <= n <= len(passages):
            errors.append(f"[{n}] 不在段落列表中")
    for quote, n in re.findall(r"「(.+?)」\[(\d+)\]", answer):
        n = int(n)
        if 1 <= n <= len(passages) and quote not in passages[n - 1]["classical_text"]:
            errors.append(f"[{n}] 没有这句 「{quote}」")
    return errors

passages = [{"classical_text": "贪狼属木,化桃花杀。贪狼入庙长耸肥胖"}]
print(check_answer("书中说贪狼 「贪狼属木」[1].", passages))
print(check_answer("书中说 「贪狼主富贵」[1],另见 [4]。", passages))[]
['[4] 不在段落列表中', '[1] 没有这句 「贪狼主富贵」']答案没通过就删掉那一句或让模型重答,不要显示。
应当保持的做法
- 书名与章节列在答案末尾,正文只留
[n]。 - 原文是汉文。 模型翻译时要注明是助手的译文,不是书中原话。
- 区分书中所说与解读:书里说了什么是有出处的事实;这些规则对人生是否成立并未经过检验,别让助手说得像定论。
- 针对某一张命盘作答时,用
charts/中该命盘sections[].passages的 id 作候选集,而不是整个库。 - 解读(
store/readings)和延伸阅读(store/further-reading,带文章的summary、faq和url)也可以放进检索库;保留id以便连回命盘的对应部分。
许可
数据采用 CC BY 4.0,代码采用 MIT。基于本数据集的助手应在用户看得到的地方注明“数据:Nhat Nguyet (nhatnguyet.org)”。代码库和测试用例见开源页面。