Huấn luyện, tinh chỉnh AI với bộ lá số Tử Vi luận sẵn
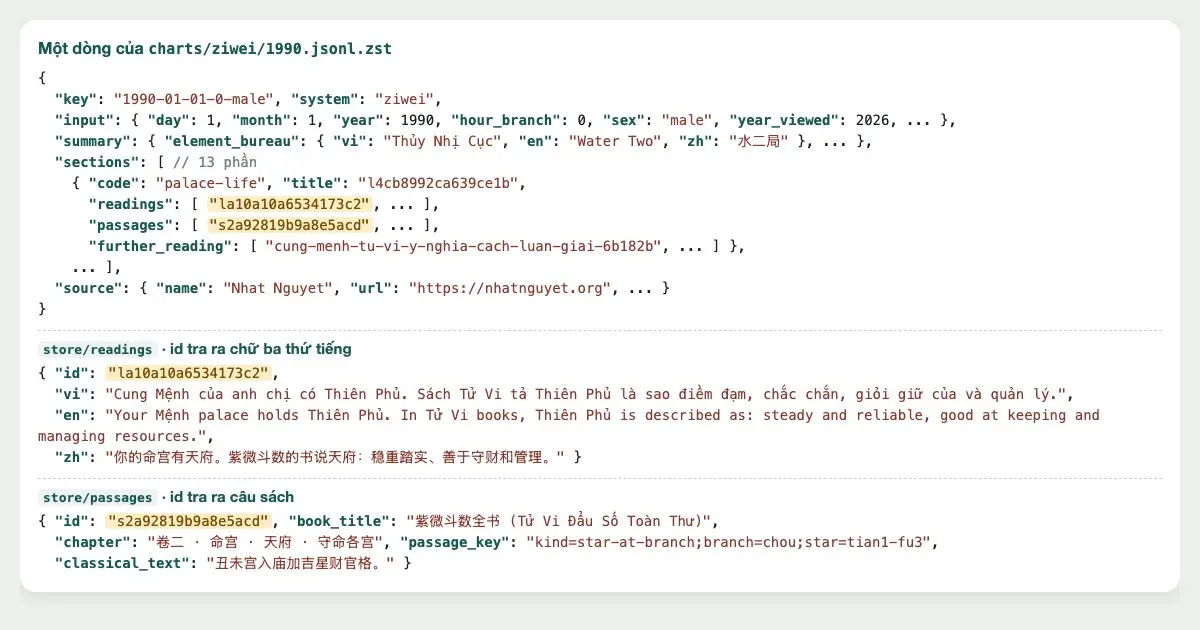
Bộ lời luận theo lá số của Nhật Nguyệt là dữ liệu sẵn để tinh chỉnh mô hình ngôn ngữ: mỗi lá số một dòng JSON, mỗi phần có lời luận ba thứ tiếng, câu sách cổ ghi sách và chương, giấy phép CC BY 4.0. Bài này em chỉ cách đọc khuôn dòng và đổi nó thành cặp hỏi đáp cho tinh chỉnh.
Bộ dữ liệu ở Hugging Face: nhatnguyet/ziwei-readings (Tử Vi), nhatnguyet/bazi-readings (Bát Tự), nhatnguyet/numerology-readings (thần số học). Tên thư mục, tên trường bằng tiếng Anh; chữ tiếng Việt nằm ở trường vi.
Bộ dữ liệu gồm những tệp nào?
Tệp lá số chia theo năm sinh, nén zstd (đuôi .jsonl.zst), mỗi dòng một đối tượng JSON. Đọc bằng Python thì cài pip install zstandard.
charts/ziwei/<năm>.jsonl.zst: mỗi lá số một dòng, chữ trong dòng thay bằng id.store/readings/ziwei.jsonl.zst,store/passages/ziwei.jsonl.zst,store/further-reading/ziwei.jsonl.zst: nơi id trỏ tới (lời luận, câu sách cổ, bài đọc thêm), mỗi loại một tệp.assembled/ziwei/<vi|en|zh>/<năm>.jsonl.zst: chữ đã ghép đủ một ngôn ngữ, dạng markdown.meta.json: khuôn từng thư mục, cách ghép id, giấy phép, câu ghi nguồn ba thứ tiếng.
Chỉ cần chữ thì đọc thẳng assembled: mỗi dòng {key, system, lang, input, text}, trong đó text là cả bản luận của một lá. Cần từng phần, từng câu sách thì đọc charts cùng store như dưới đây.
Một dòng lá số gồm những gì?
Lá Tử Vi có 13 phần: tổng quan và 12 cung.
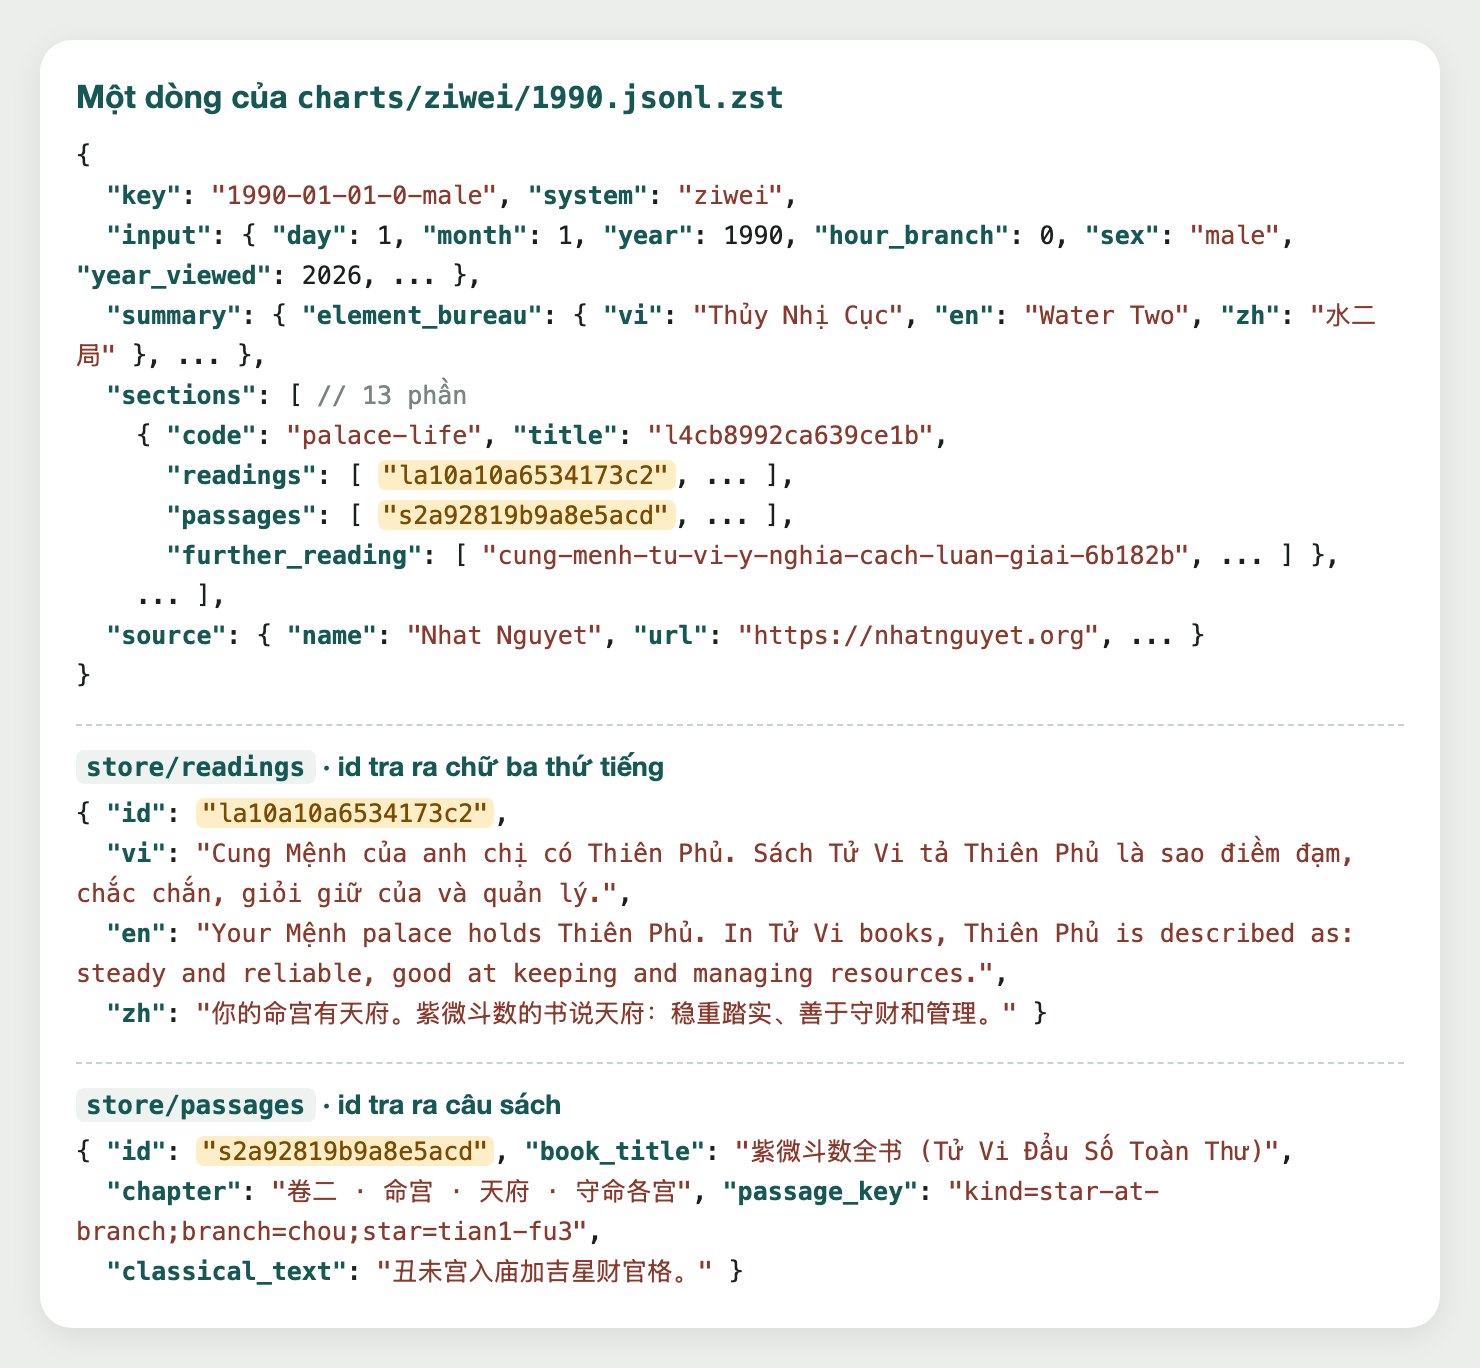
| khoá | nội dung |
|---|---|
key | mã lá: ngày sinh, chỉ số giờ, giới (1990-01-01-0-male) |
input | đầu vào: ngày, tháng, năm, canh giờ, giới, năm xem 2026 |
summary | lá số có cấu trúc: cục, mệnh nạp âm, Mệnh tại chi nào, cách cục, đại vận, hạn năm, chữ đủ ba thứ tiếng |
sections[].code | mã phần: overview, palace-life... |
sections[].chart | ô cung của phần ấy: chi, can chi, các sao kèm độ sáng |
sections[].title, sections[].readings | id tên phần và id từng mẩu lời luận, tra trong store/readings ra vi, en, zh; lời dựng từ lõi tính, không do mô hình viết |
sections[].steps | bước tính (an cung Mệnh, định cục...), mỗi bước có name, input, formula, intermediate, result là id trong store/readings |
sections[].passages | id câu sách cổ phạm vi công cộng, tra trong store/passages ra sách, tác giả, chương, khoá tra, nguyên văn |
sections[].further_reading | slug bài kiến thức, tra trong store/further-reading |
source | tên, địa chỉ, giấy phép, câu ghi nguồn |
Các bước dựng tập tinh chỉnh
- Tải
meta.json, tệp năm cần dùngcharts/ziwei/1990.jsonl.zstvà kho lời luậnstore/readings/ziwei.jsonl.zst, chẳng hạn bằnghf download nhatnguyet/ziwei-readings meta.json charts/ziwei/1990.jsonl.zst store/readings/ziwei.jsonl.zst --repo-type dataset --local-dir .(lệnhhfcó trong góihuggingface_hub). - Nạp kho lời luận thành bảng tra từ id ra chữ ba thứ tiếng.
- Đọc từng dòng lá số; mỗi phần có lời luận thành một mẫu, mỗi ngôn ngữ một mẫu.
- Câu hỏi dựng từ
inputvàsummarycủa chính lá; câu trả lời là các id trongreadingstra ra chữ rồi nối lại. - Gắn vào mỗi mẫu câu ghi nguồn đúng ngôn ngữ của mẫu:
attributiontrongmeta.jsoncó đủvi,en,zh. - Ghi ra JSONL theo khuôn
messagesmà phần lớn công cụ tinh chỉnh đọc được.
import io, json
import zstandard  # pip install zstandard

def read(path):
    """Đọc một tệp .jsonl.zst, mỗi dòng một đối tượng JSON."""
    with open(path, "rb") as f:
        for line in io.TextIOWrapper(zstandard.ZstdDecompressor().stream_reader(f), encoding="utf-8"):
            yield json.loads(line)

# Kho lời luận: id -> {vi, en, zh}, một tệp cho cả bộ.
TEXT = {x["id"]: x for x in read("store/readings/ziwei.jsonl.zst")}
CREDIT = json.load(open("meta.json", encoding="utf-8"))["attribution"]  # {"vi": ..., "en": ..., "zh": ...}

TEMPLATE = {  # khuôn câu hỏi theo ngôn ngữ
    "vi": ("Sinh {date}, giờ {hour}, {sex}. Lá {year}, {bureau}, Mệnh tại {life}. Luận {section}.", {"male": "nam", "female": "nữ"}),
    "en": ("Born {date}, {hour} hour, {sex}. Chart: {year}, {bureau}, Mệnh at {life}. Read the {section}.", {"male": "male", "female": "female"}),
    "zh": ("{date}生,{hour}时,{sex}。命盘:{year},{bureau},命宫在{life}。论{section}。", {"male": "男", "female": "女"}),
}

count, first = 0, []
with open("fine-tune.jsonl", "w", encoding="utf-8") as out:
    for chart in read("charts/ziwei/1990.jsonl.zst"):
        i, s = chart["input"], chart["summary"]
        for section in chart["sections"]:
            if not section["readings"]:
                continue
            for lang, (template, sex) in TEMPLATE.items():
                question = template.format(date=f"{i['day']}/{i['month']}/{i['year']}", hour=i["hour_name"][lang],
                                           sex=sex[i["sex"]], year=s["year_stem_branch"][lang], bureau=s["element_bureau"][lang],
                                           life=s["life_palace_branch"][lang], section=TEXT[section["title"]][lang])
                answer = "\n".join(TEXT[x][lang] for x in section["readings"])
                sample = {"messages": [{"role": "user", "content": question},
                                       {"role": "assistant", "content": answer}],
                          "source": CREDIT[lang]}
                out.write(json.dumps(sample, ensure_ascii=False) + "\n")
                count += 1
                if len(first) < 6:
                    first.append(sample)

print("Số mẫu:", count)
for m in first[3:6]:
    print(m["messages"][0]["content"])
    print("  ->", m["messages"][1]["content"][:150], "...")
print(" ", m["source"])Số mẫu: 323106
Sinh 1/1/1990, giờ Tý, nam. Lá Kỷ Tỵ, Thủy Nhị Cục, Mệnh tại Sửu. Luận Cung Mệnh.
-> Cung Mệnh của anh chị có Thiên Phủ. Sách Tử Vi tả Thiên Phủ là sao điềm đạm, chắc chắn, giỏi giữ của và quản lý.
Sách Tử Vi tả Thiên Phủ là sao kho: đ ...
Dữ liệu: Nhật Nguyệt (nhatnguyet.org)
Born 1/1/1990, Tý hour, male. Chart: Kỷ Tỵ, Water Two, Mệnh at Sửu. Read the Life Palace.
-> Your Mệnh palace holds Thiên Phủ. In Tử Vi books, Thiên Phủ is described as: steady and reliable, good at keeping and managing resources.
Tử Vi books ...
Data: Nhat Nguyet (nhatnguyet.org)
1/1/1990生,子时,男。命盘:己巳,水二局,命宫在丑。论命宫。
-> 你的命宫有天府。紫微斗数的书说天府:稳重踏实、善于守财和管理。
紫微书中称天府为库星:稳重谨慎,善于积累和管理,可靠;另一面是保守、怕冒险。在命宫(自身),天府处平之位:上述特点表现一般。
以文昌所在宫为初一,顺数至生日,再退一宫。
以文曲所在宫为初一,逆数至生日,再退一宫(越南书的排法;中国书顺数 ...
数据:Nhat Nguyet (nhatnguyet.org)8.760 lá số năm 1990 (365 ngày, 12 canh giờ, hai giới) cho 323.106 mẫu đủ ba thứ tiếng; tệp ra khoảng 276 MB. Tệp charts năm 1990 chỉ nặng 6,7 MB vì mỗi câu nằm một lần trong kho. Bản assembled cùng năm nặng 18,4 MB tiếng Việt, 14,8 MB tiếng Anh, 12,2 MB tiếng Trung.
Nên lưu ý gì khi huấn luyện?
- Lời luận Việt gọi người xem là "anh chị"; mô hình học xong sẽ nói theo giọng ấy.
- Câu sách cổ là nguyên văn chữ Hán, chưa dịch. Muốn mô hình trích sách thì tra id trong
passagesrastore/passagesvà giữbook_title,chaptercạnhclassical_text, đừng chỉ giữ chữ. - Tách tập kiểm theo lá số, không theo mẫu: ba bản ngôn ngữ của cùng một phần mà nằm hai bên thì điểm đánh giá đẹp giả.
- Lời luận nói theo quy tắc của một phái Tử Vi, chưa được kiểm chứng. Mô hình học được cách phái ấy đọc lá số, không học được điều gì đúng về đời người; khi đưa vào sản phẩm thì nói rõ như vậy.
Giấy phép và ghi nguồn
Dữ liệu theo CC BY 4.0: được dùng huấn luyện, kể cả cho sản phẩm thương mại, với điều kiện ghi "Dữ liệu: Nhật Nguyệt (nhatnguyet.org)". Câu sách cổ thuộc phạm vi công cộng; phần chia đoạn, gắn với lá số và đối chiếu bản in do Nhật Nguyệt làm, cùng giấy phép ấy.