Dựng trợ lý AI trả lời có trích dẫn sách cổ
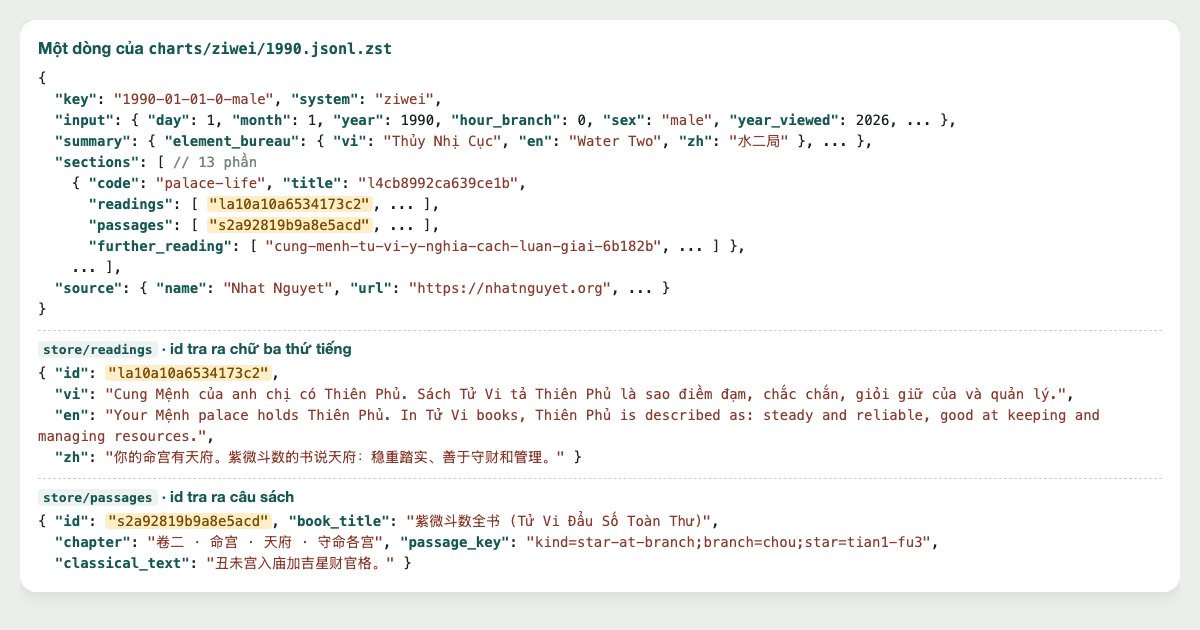
Trợ lý AI trả lời có trích dẫn sách cổ cần ba thứ: kho đoạn có ghi sách và chương, phép tìm đúng đoạn cho câu hỏi, và lời dặn chỉ trả lời từ đoạn đã đánh số. Bộ lời luận của Nhật Nguyệt có sẵn thứ thứ nhất: mỗi đoạn trong store/passages mang tên sách, tác giả, chương, khoá tra (passage_key: sao, cung, cách) và nguyên văn (classical_text), còn lá số trỏ tới đoạn ấy bằng id trong sections[].passages.
Bộ dữ liệu ở Hugging Face: nhatnguyet/ziwei-readings (Tử Vi), nhatnguyet/bazi-readings, nhatnguyet/numerology-readings. Tên thư mục, tên trường, mã khoá bằng tiếng Anh.
Các bước
- Nạp kho câu sách
store/passages/ziwei.jsonl.zst. Kho đã bỏ bản lặp, mỗi đoạn mộtid. - Lọc theo khoá: câu hỏi về Tham Lang ở cung Mệnh thì chỉ xét đoạn có khoá
star=tan-langvàpalace=life. - Xếp các đoạn còn lại theo độ gần với câu hỏi. Ví dụ dưới đếm cặp chữ chung; làm thật thì thay bằng vector.
- Đánh số đoạn, đưa vào lời nhắc kèm lời dặn: chỉ dùng đoạn đã đánh số, mỗi ý ghi
[n]. - Kiểm câu trả lời trước khi hiện: số dẫn phải có thật, câu trích phải nằm nguyên văn trong đoạn.
Mã tìm đoạn và dựng lời nhắc
Tệp nén zstd (đuôi .jsonl.zst), nên cài pip install zstandard trước, tải kho câu sách (chẳng hạn hf download nhatnguyet/ziwei-readings store/passages/ziwei.jsonl.zst --repo-type dataset --local-dir .), rồi chạy trong thư mục ấy.
import io, json
from collections import Counter
import zstandard  # pip install zstandard

def read(path):
    """Đọc một tệp .jsonl.zst, mỗi dòng một đối tượng JSON."""
    with open(path, "rb") as f:
        for line in io.TextIOWrapper(zstandard.ZstdDecompressor().stream_reader(f), encoding="utf-8"):
            yield json.loads(line)

# Bước 1: nạp kho câu sách. Mỗi đoạn một id, không lặp; một tệp cho cả bộ.
passages = list(read("store/passages/ziwei.jsonl.zst"))
print("Số đoạn sách khác nhau:", len(passages))

# Bước 2 và 3: lọc theo khoá (sao, cung) rồi xếp theo số cặp chữ trùng với câu hỏi
def key(p):
    return dict(f.split("=", 1) for f in p["passage_key"].split(";"))

def pairs(s):
    return Counter(s[i:i + 2] for i in range(len(s) - 1))

def search(question, star, palace=None, k=3):
    candidates = [p for p in passages if key(p).get("star") == star and (palace is None or key(p).get("palace") == palace)]
    q = pairs(question)
    found, seen = [], set()  # một câu sách có thể mang nhiều khoá: chỉ lấy một lần
    for p in sorted(candidates, key=lambda p: -sum((q & pairs(p["classical_text"])).values())):
        if p["classical_text"][:40] not in seen:
            seen.add(p["classical_text"][:40])
            found.append(p)
    return found[:k]

# Bước 4: dựng lời nhắc có số dẫn
found = search("贪狼在命宫遇化权", star="tan-lang", palace="life")
block = "\n".join(f"[{i}] {p['book_title_vi']}, {p['chapter']}: {p['classical_text'].splitlines()[0][:48]}" for i, p in enumerate(found, 1))
print(block)
print("---")
print("Chỉ trả lời bằng các đoạn đã đánh số ở trên, mỗi ý ghi [n]. Đoạn nào không nói thì nói là sách không nói.")Số đoạn sách khác nhau: 1015
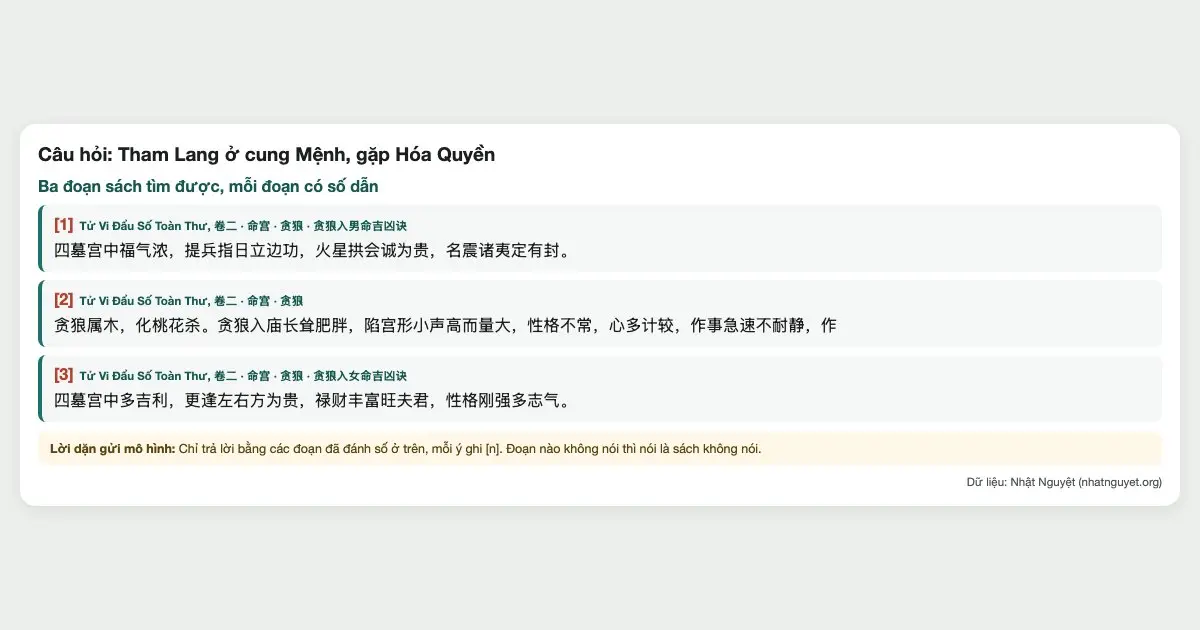
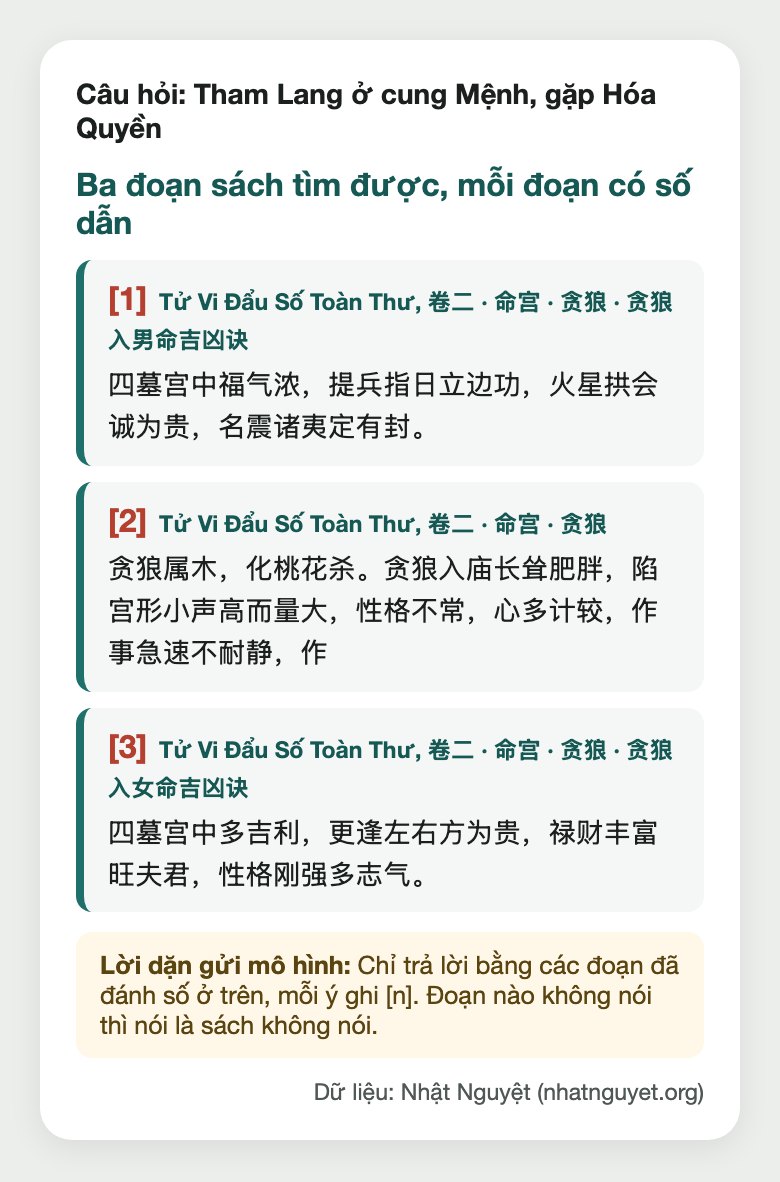
[1] Tử Vi Đẩu Số Toàn Thư, 卷二 · 命宫 · 贪狼 · 贪狼入男命吉凶诀: 四墓宫中福气浓,提兵指日立边功,火星拱会诚为贵,名震诸夷定有封。
[2] Tử Vi Đẩu Số Toàn Thư, 卷二 · 命宫 · 贪狼: 贪狼属木,化桃花杀。贪狼入庙长耸肥胖,陷宫形小声高而量大,性格不常,心多计较,作事急速不耐静,作
[3] Tử Vi Đẩu Số Toàn Thư, 卷二 · 命宫 · 贪狼 · 贪狼入女命吉凶诀: 四墓宫中多吉利,更逢左右方为贵,禄财丰富旺夫君,性格刚强多志气。
---
Chỉ trả lời bằng các đoạn đã đánh số ở trên, mỗi ý ghi [n]. Đoạn nào không nói thì nói là sách không nói.Kho câu sách Tử Vi có 1.015 đoạn khác nhau: 1.004 đoạn từ Tử Vi Đẩu Số Toàn Thư bản thường, 11 đoạn từ bản khắc Minh Nam Dương Đường. Riêng 8.760 lá số năm 1990 dẫn tới 984 đoạn trong số ấy. Truyền thống quy sách cho Trần Đoàn, La Hồng Tiên đề tựa năm 1550; nghiên cứu hiện đại chưa coi việc quy tác giả ấy là đã chứng minh, nên hai trường author_vi, author_en ghi đúng như vậy.
Kiểm câu trả lời trước khi hiện
Mô hình có lúc dẫn số không có hoặc "trích" câu sách không nói. Hàm dưới bắt cả hai trước khi chữ tới người đọc.
import re

def check_answer(answer, passages):
    """Mỗi [n] phải trỏ tới đoạn có thật; câu trong ngoặc kép phải nằm nguyên văn trong đoạn ấy."""
    errors = []
    for n in map(int, re.findall(r"\[(\d+)\]", answer)):
        if not 1 <= n <= len(passages):
            errors.append(f"[{n}] không có trong danh sách đoạn")
    for quote, n in re.findall(r"「(.+?)」\[(\d+)\]", answer):
        n = int(n)
        if 1 <= n <= len(passages) and quote not in passages[n - 1]["classical_text"]:
            errors.append(f"[{n}] không có câu 「{quote}」")
    return errors

passages = [{"classical_text": "贪狼属木,化桃花杀。贪狼入庙长耸肥胖"}]
print(check_answer("Sách tả Tham Lang 「贪狼属木」[1].", passages))
print(check_answer("Sách nói 「贪狼主富贵」[1], xem thêm [4].", passages))[]
['[4] không có trong danh sách đoạn', '[1] không có câu 「贪狼主富贵」']Câu trả lời có lỗi thì anh chị bỏ câu ấy hoặc hỏi lại mô hình, đừng hiện.
Những điều nên giữ
- Hiện tên sách và chương ở danh mục cuối câu trả lời, trong thân chỉ ghi
[n]. - Nguyên văn là chữ Hán. Mô hình dịch thì ghi rõ đó là bản dịch của trợ lý, không phải lời sách.
- Phân biệt lời sách với lời giải: sách nói gì là dữ kiện có nguồn; còn quy tắc trong sách đúng với đời người hay không thì chưa được kiểm chứng, đừng để trợ lý nói như điều chắc chắn.
- Trả lời theo một lá số cụ thể thì lấy đúng các id trong
sections[].passagescủa lá ấy ởcharts/làm tập ứng viên, thay vì cả kho. - Lời luận (
store/readings) và bài đọc thêm (store/further-reading, cósummary,faqvàurlcủa bài) cũng đưa được vào kho tìm; giữidđể nối ngược về phần của lá số.
Giấy phép
Dữ liệu theo CC BY 4.0, mã theo MIT. Trợ lý dùng bộ này thì ghi "Dữ liệu: Nhật Nguyệt (nhatnguyet.org)" ở chỗ người dùng thấy được. Kho mã và bộ ca kiểm ở trang mã nguồn mở.